Künstliche Intelligenz kann pädagogische Fachkräfte unterstützen. Doch woher weiß eine KI eigentlich, ob ihre Antworten fachlich richtig sind? Gerade in der Frühpädagogik ist diese Frage entscheidend. Denn wenn es um die Entwicklung von Kindern, pädagogische Qualität, Inklusion oder die Zusammenarbeit mit Familien geht, reichen überzeugend klingende Antworten allein nicht aus.
Mit der ECE Wissens-Pipeline v1.0 hat Kita Digital einen technischen Ansatz entwickelt, um wissenschaftliche Fachliteratur automatisiert zu recherchieren, systematisch aufzubereiten und für lokale KI-Systeme nutzbar zu machen. Der dazugehörige Forschungsbericht von Sebastian Götz, veröffentlicht am 18. Oktober 2026, dokumentiert die Architektur, die Ergebnisse eines Literaturverarbeitungslaufs und einen explorativen Vergleich zwischen einem lokalen KI-System mit wissenschaftlicher Wissensbasis und Google Gemini 3.1 Pro.
Die zentrale Erkenntnis: Wissenschaftliche Quellen können KI-Antworten nachvollziehbarer machen. Sie garantieren aber noch keine fehlerfreien Ergebnisse.
Warum braucht KI in der Frühpädagogik eigenes Fachwissen?
Wer einer allgemeinen KI eine Frage zur frühkindlichen Bildung stellt, erhält häufig innerhalb weniger Sekunden eine ausführliche Antwort. Das Problem: Sprachmodelle verfügen zwar über breites Wissen, unterscheiden aber nicht immer zuverlässig zwischen schulischer Bildung, Erwachsenenbildung und den besonderen Anforderungen von Kindertageseinrichtungen. Dabei folgt pädagogisches Handeln in der Kita anderen Grundsätzen als der Unterricht in einer Schule.
Ein Beispiel: Eine pädagogische Fachkraft möchte wissen, welche Bedeutung das freie Spiel für die Entwicklung von Kindern hat. Eine allgemeine KI könnte passende theoretische Erklärungen liefern. Ob ihre Aussagen aber tatsächlich durch frühpädagogische Studien gestützt werden, bleibt möglicherweise unklar.
Genau hier setzt das Forschungsprojekt von Kita Digital an. Statt ausschließlich auf das allgemeine Wissen eines Sprachmodells zurückzugreifen, soll die KI gezielt wissenschaftliche Veröffentlichungen aus dem Bereich Early Childhood Education and Care (ECEC) nutzen können. Dazu gehören unter anderem Forschungsarbeiten über:
- Frühkindliche Entwicklung und Bildungsprozesse
- Spielpädagogik und kindliches Lernen
- Beobachtung und pädagogische Qualität
- Inklusion und individuelle Förderung
- Professionalisierung pädagogischer Fachkräfte
- Zusammenarbeit zwischen Kita, Familien und weiteren Bildungsorten
Das Ziel ist eine nachvollziehbare Wissensgrundlage, die stärker auf die Besonderheiten der frühen Bildung ausgerichtet ist.
Was ist die ECE Wissens-Pipeline?
Die ECE Wissens-Pipeline v1.0 ist ein von Kita Digital entwickeltes, Python-basiertes System zur automatisierten Aufbereitung wissenschaftlicher Fachliteratur. Sie soll aus umfangreichen wissenschaftlichen Veröffentlichungen einen strukturierten, thematisch passenden und technisch nutzbaren Wissensbestand erstellen.
Dabei geht es nicht einfach darum, möglichst viele PDF-Dateien herunterzuladen. Eine wissenschaftliche Publikation muss gefunden, auf ihre thematische Relevanz geprüft, hinsichtlich ihrer Nutzungsbedingungen eingeordnet und anschließend technisch so aufbereitet werden, dass ein KI-System die Inhalte sinnvoll durchsuchen kann.
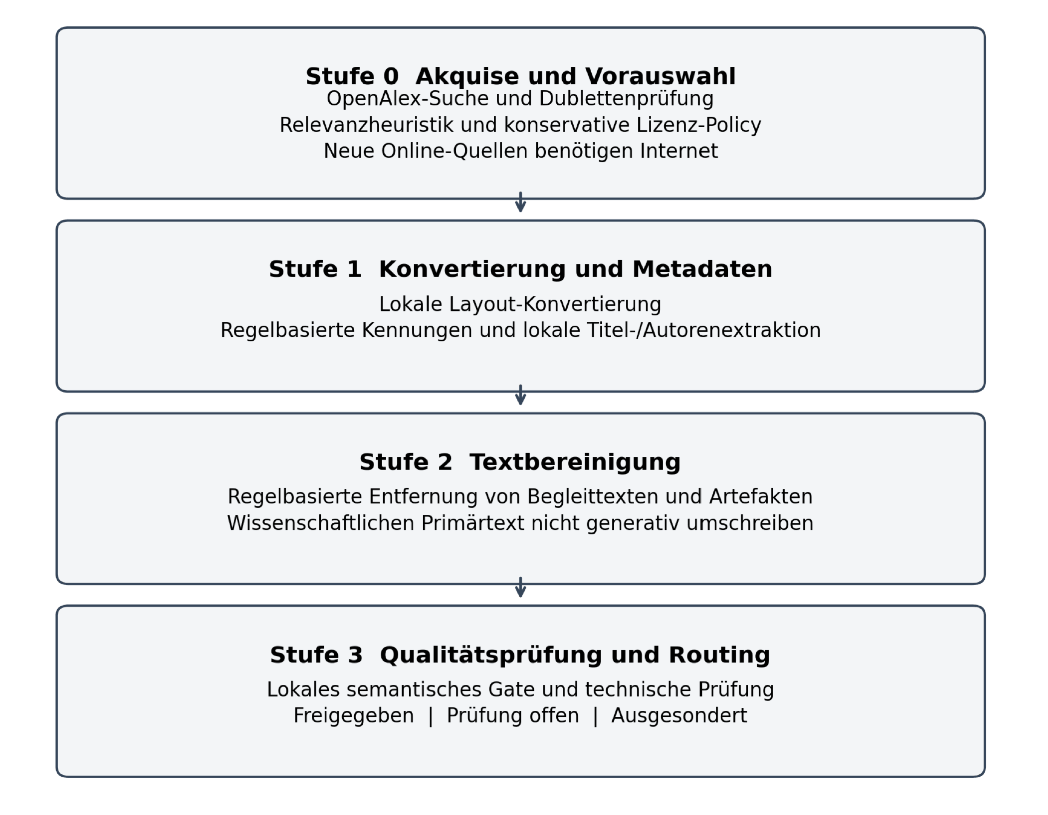
Die Pipeline arbeitet dafür in vier Stufen.
1. Wissenschaftliche Fachliteratur recherchieren
Im ersten Schritt werden frei zugängliche wissenschaftliche Veröffentlichungen über OpenAlex und angebundene Quellen recherchiert. Ein regelbasiertes Verfahren untersucht Titel, Zusammenfassungen und weitere Metadaten auf frühpädagogische Relevanz. Zusätzlich berücksichtigt das System Lizenzinformationen, um nur solche Quellen automatisch weiterzuverarbeiten, die den festgelegten konservativen Freigabekriterien entsprechen.
2. PDF-Dokumente in nutzbare Texte umwandeln
Die gefundenen wissenschaftlichen PDFs werden anschließend in strukturierte Markdown-Dateien umgewandelt. Das ist wichtig, weil Sprachmodelle nicht automatisch erkennen, welche Textteile wissenschaftliche Ergebnisse enthalten und welche lediglich Seitenzahlen, Verlagsinformationen oder technische Bestandteile eines Dokuments darstellen. Eine lokale KI unterstützt die Erkennung ausgewählter Metadaten, beispielsweise von Titel und Autor.
3. Störende Textelemente entfernen
Im dritten Arbeitsschritt entfernt die Pipeline regelbasiert störende Bestandteile wie wiederholte Kopfzeilen, technische Markierungen oder bestimmte Verlagsinformationen. Eine Besonderheit: Die wissenschaftlichen Primärtexte werden nicht von einem Sprachmodell zusammengefasst oder generativ umgeschrieben. Damit soll vermieden werden, dass ein generatives Modell bereits während der Datenaufbereitung eigenständig Inhalte verändert. Auch eine regelbasierte Bereinigung kann allerdings Fehler verursachen. Deshalb bleibt eine anschließende Qualitätsprüfung erforderlich.
4. Qualität prüfen und Dokumente freigeben
Abschließend werden die Dokumente technisch und semantisch geprüft. Je nach Ergebnis werden sie für den Wissensbestand freigegeben, einer manuellen Prüfung zugeordnet oder aussortiert. So entsteht schrittweise der ECE-Research-Corpus, ein spezialisierter Forschungsdatenbestand für die Frühpädagogik.
Forschungsergebnis: Von 2.262 wissenschaftlichen Werken zu 151 Korpusdokumenten
Wie arbeitet eine solche Pipeline unter dokumentierten Bedingungen? Um diese Frage zu untersuchen, wurde ein begrenzter Such- und Verarbeitungslauf mit wissenschaftlichen Veröffentlichungen aus dem Publikationsjahr 2014 ausgewertet. Die Ergebnisse zeigen, wie viele Auswahl- und Verarbeitungsschritte zwischen einer Literaturrecherche und einem technisch nutzbaren KI-Wissensbestand liegen.
| Untersuchungsschritt | Ergebnis |
|---|---|
| Eindeutige recherchierte Werke | 2.262 |
| Als thematisch nicht ausreichend relevant ausgeschlossen | 1.056 |
| Nach Relevanz- und Dublettenprüfung zur Lizenzprüfung | 1.199 |
| Nach der konservativen Lizenz-Policy zugelassen | 278 |
| Erfolgreich heruntergeladene und technisch validierte PDFs | 203 |
| Zur manuellen Prüfung weitergeleitet | 28 |
| Aus weiteren Gründen nicht übernommen | 24 |
| In den Korpus übernommen | 151 |
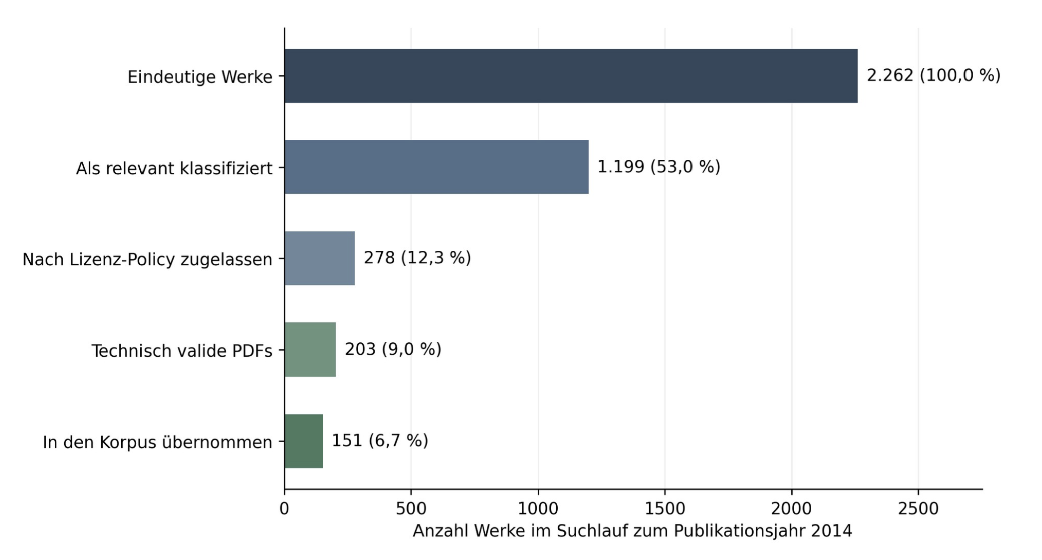
Damit gelangten rund 6,7 Prozent der ursprünglich betrachteten eindeutigen Werke in den finalen Bestand dieses Suchlaufs. Das bedeutet ausdrücklich nicht, dass die übrigen Veröffentlichungen wissenschaftlich minderwertig waren.
Viele wurden aufgrund der thematischen Auswahlregeln, unklarer Lizenzinformationen oder technischer Anforderungen nicht übernommen. Die Auswertung macht deutlich, dass für ein spezialisiertes KI-Wissenssystem nicht nur die Menge der gefundenen Literatur entscheidend ist, sondern vor allem deren nachvollziehbare Auswahl und Aufbereitung. Damit gelangten rund 6,7 Prozent der ursprünglich betrachteten eindeutigen Werke in den finalen Bestand dieses Suchlaufs. Das bedeutet ausdrücklich nicht, dass die übrigen Veröffentlichungen wissenschaftlich minderwertig waren. Viele wurden aufgrund der thematischen Auswahlregeln, unklarer Lizenzinformationen oder technischer Anforderungen nicht übernommen. Die Auswertung macht deutlich, dass für ein spezialisiertes KI-Wissenssystem nicht nur die Menge der gefundenen Literatur entscheidend ist, sondern vor allem deren nachvollziehbare Auswahl und Aufbereitung.
Wichtig ist außerdem: Die 151 Dokumente beziehen sich ausschließlich auf den untersuchten Suchlauf für das Publikationsjahr 2014 und nicht auf die Gesamtgröße des fortlaufend entwickelten ECE-Research-Corpus.
Wie beantwortet eine lokale KI wissenschaftliche Fachfragen?
Der Forschungsbericht untersucht neben der Literaturaufbereitung auch die Verwendung wissenschaftlicher Quellen bei der KI-gestützten Beantwortung von Fachfragen. Dafür wurde ein lokales System mit Retrieval-Augmented Generation (RAG) eingesetzt.
Was bedeutet Retrieval-Augmented Generation?
Retrieval-Augmented Generation bedeutet vereinfacht, dass ein Sprachmodell vor der Antwort passende Informationen aus einer angeschlossenen Wissenssammlung abruft. Statt eine Frage ausschließlich auf Grundlage seiner trainierten Modellgewichte zu beantworten, erhält die KI zusätzlich relevante Textpassagen aus wissenschaftlichen Veröffentlichungen. Ein Beispiel:
Eine Kita-Leitung fragt, welche Zeitressourcen für die Praxisanleitung angehender Erzieherinnen und Erzieher vorgesehen sind. Ein RAG-System kann gezielt in vorhandenen Forschungsarbeiten nach entsprechenden Angaben suchen und diese für seine Antwort verwenden. Das macht es grundsätzlich möglich, fachliche Aussagen mit konkreten Quellen abzugleichen. RAG ist jedoch keine automatische Wahrheitsprüfung. Entscheidend bleibt, welche Textstellen gefunden werden und ob das Sprachmodell diese richtig interpretiert.
Lokale RAG-KI im Vergleich mit Gemini 3.1 Pro
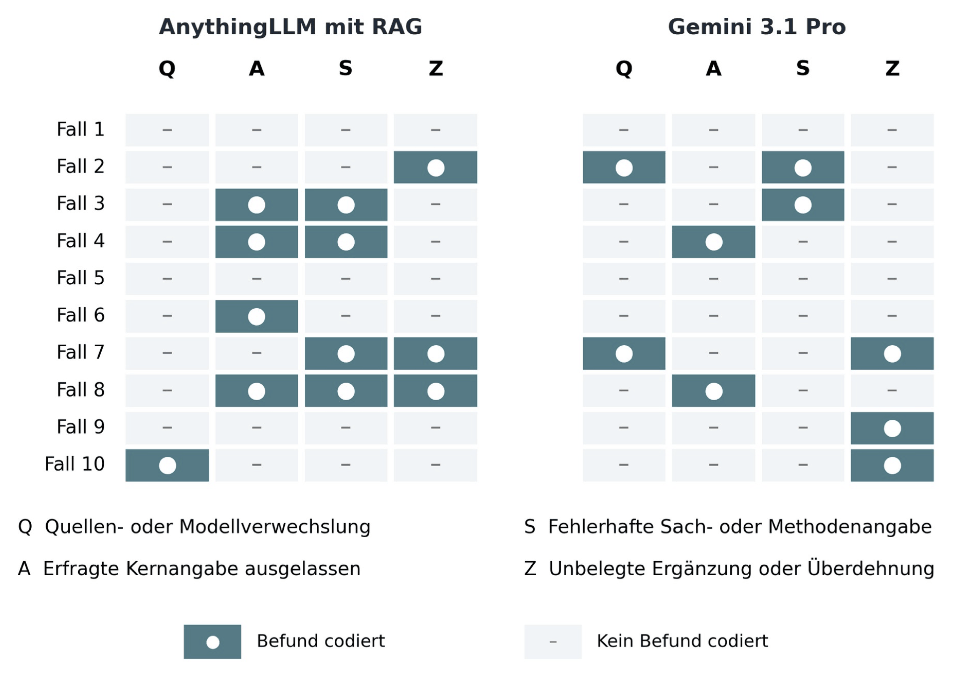
Für den Forschungsbericht wurden zehn dokumentierte Fachfragen mit zwei unterschiedlichen KI-Systemen bearbeitet. Zum Einsatz kamen:
- Lokales RAG-System: AnythingLLM mit einem über Ollama lokal betriebenen Qwen-Sprachmodell und wissenschaftlichen Dokumenten.
- Gemini 3.1 Pro: Das Cloud-Sprachmodell wurde mit der Einstellung „Denkaufwand hoch“ verwendet.
Die zehn Antwortpaare wurden anschließend qualitativ mit sieben wissenschaftlichen Quelldokumenten verglichen.
Ergebnis 1: Die lokale KI war bei mehreren Studienfragen näher an den Quellen
Bei verschiedenen Fragen zu konkreten wissenschaftlichen Veröffentlichungen konnte das lokale RAG-System relevante Studienergebnisse präziser wiedergeben. Beispielsweise wurden bei einer Frage zu Führungsverhalten und emotionaler Erschöpfung zentrale statistische Zusammenhänge durch das RAG-System korrekt dargestellt. Gemini beschrieb dagegen bestimmte Zusammenhänge zu stark und machte Fehler bei der Darstellung des Studiendesigns. Auch bei einer Frage zu Spiel und Lernzielen bezog sich die lokale RAG-Antwort auf die passende Untersuchung, während Gemini eine andere Studie heranzog. Das zeigt, welches Potenzial eine gezielt aufgebaute wissenschaftliche Wissensbasis besitzt.
Ergebnis 2: Auch die lokale KI machte Fehler
Die Untersuchung zeigte ebenso deutlich, dass ein RAG-System nicht automatisch vollständige oder korrekte Antworten liefert. Bei einer Frage zur Praxisanleitung gab das lokale System zwei Angaben korrekt wieder:
- 62 Prozent der ausbildenden Einrichtungen verfügten über geregelte Zeitkontingente.
- Wenn solche Zeitkontingente vorhanden waren, betrug ihr durchschnittlicher Umfang 2,06 Wochenstunden.
Eine weitere erfragte Kennzahl von 34 Prozent auf Trägerebene wurde jedoch ausgelassen. Die Information war in den zugrunde liegenden Dokumenten vorhanden. Bei anderen Fragen entstanden unbelegte Ergänzungen oder Probleme bei der Identifikation einer Quelle. Das verdeutlicht: Die richtige Information im Wissensbestand zu haben, bedeutet noch nicht, dass die KI sie zuverlässig verwendet.
Ergebnis 3: Allgemeine KI konnte bei offenen Praxisfragen konkreter sein
Nicht bei jeder Aufgabe lag der Vorteil aufseiten des lokalen RAG-Systems. Bei einer Frage zur kontinuierlichen Fortbildung pädagogischer Fachkräfte formulierte Gemini konkretere Vorschläge, beispielsweise zu Hospitationen, Coaching und Qualitätszirkeln. Die lokale RAG-Antwort blieb abstrakter, obwohl passende Informationen im geprüften Dokumentenbestand enthalten waren. Diese Ergebnisse machen deutlich, dass Quellenzugang, Vollständigkeit und praktische Nutzbarkeit unterschiedliche Qualitätsdimensionen sind.
Ergebnis 4: Beide Systeme erkannten eine falsche Fragevoraussetzung
Eine Kontrollfrage enthielt die Behauptung, eine bestimmte Studie habe ein zwölfwöchiges Coachingprogramm untersucht. Das war nicht der Fall. Beide KI-Systeme vermieden es, einen erfundenen Prozentwert für das vermeintliche Programm anzugeben. Allerdings enthielten die Antworten weitere Unstimmigkeiten bei der Einordnung der Quelle. Auch dieser Fall zeigt, weshalb einzelne erfolgreiche Antworten keine Garantie für allgemeine Zuverlässigkeit darstellen.
Bedeutet das, dass lokale KI besser als Gemini ist?
Nein. Eine solche Schlussfolgerung wäre wissenschaftlich nicht gerechtfertigt. Die zehn dokumentierten Antwortpaare bilden eine explorative Fallserie, keinen repräsentativen Leistungstest. Die Fragen wurden anhand der vorhandenen wissenschaftlichen Quellen entwickelt. Das begünstigt erwartbar ein System, dem diese Dokumente unmittelbar zur Verfügung stehen. Außerdem wurden zwei unterschiedliche Sprachmodelle mit unterschiedlichen Rahmenbedingungen verglichen. Es gab keinen kontrollierten Vergleich desselben Modells mit und ohne RAG. Auch die Cloud-Zusatzfunktionen von Gemini und mögliche weitere Kontexteinflüsse waren nicht vollständig protokolliert. Der Forschungsbericht zeigt deshalb konkrete Stärken und Schwächen beider Systeme, aber keine allgemeine Überlegenheit einer Technologie.
Kann die ECE Wissens-Pipeline auch ohne Internet funktionieren?
Ein weiteres zentrales Thema des Forschungsprojekts ist die technische Unabhängigkeit von Cloud-KI-Diensten. Die ECE Wissens-Pipeline wurde so konzipiert, dass bereits vorhandene Dokumente nach der vollständigen Einrichtung lokal verarbeitet werden können. Auch das spätere RAG-System kann vollständig lokal arbeiten, wenn sämtliche erforderlichen Komponenten auf dem eigenen Rechner oder Server bereitstehen.
Dazu gehören:
- Ein lokal ausführbares Sprachmodell
- Ein lokales Embedding-Modell zur Verarbeitung von Suchanfragen und Dokumenten
- Eine lokale Vektordatenbank zum Auffinden relevanter Inhalte
- Sämtliche benötigten wissenschaftlichen Dokumente
Für den dokumentierten Aufbau wurde ein MacBook Pro mit Apple M3 Max und 128 GB gemeinsamem Arbeitsspeicher verwendet. Diese Hardware ist die untersuchte Konfiguration und keine nachgewiesene Mindestanforderung. Die Suche nach neuen wissenschaftlichen Online-Veröffentlichungen, der Download neuer Quellen und externe Aktualisierungen benötigen weiterhin eine Internetverbindung. Nach vollständiger Einrichtung können vorhandene Dokumente und Fachfragen jedoch ohne laufende Cloud-Inferenz verarbeitet werden, sofern keine externen Dienste oder Cloud-Fallbacks aktiv sind. Ein gesonderter, kontrolliert protokollierter Test bei getrennter Internetverbindung wurde im Forschungsbericht noch nicht durchgeführt.
Warum ist lokale KI für Kita-Träger interessant?
Für Kommunen und Kita-Träger kann eine solche Architektur insbesondere mit Blick auf die Datenhoheit interessant sein. Wenn Sprachmodelle und Wissensspeicher innerhalb der eigenen Infrastruktur betrieben werden, lässt sich die Abhängigkeit von externen KI-Diensten reduzieren. Lokale Verarbeitung bedeutet allerdings nicht automatisch vollständige Datenschutzkonformität. Zugriffsschutz, Berechtigungen, Aufbewahrungsregeln und die konkrete Systemkonfiguration müssen weiterhin geprüft werden. Auch fachlich gilt: Ein lokal betriebenes Sprachmodell kann falsche Antworten erzeugen. Digitale Souveränität, Datenschutz und pädagogische Zuverlässigkeit sind wichtige, aber unterschiedliche Anforderungen.
Was bedeutet die Forschung für den Kita-Alltag?
Die ECE Wissens-Pipeline ist zunächst eine Forschungs- und Dateninfrastruktur. Ihre pädagogische Wirksamkeit im Kita-Alltag wurde mit diesem Bericht nicht nachgewiesen. Dennoch entstehen aus der Architektur interessante Perspektiven für künftige Assistenzsysteme. Denkbar sind unter anderem die Unterstützung bei der Recherche für pädagogische Konzeptionen, die wissenschaftliche Einordnung von Qualitätsentwicklungsmaßnahmen oder das Auffinden einschlägiger Studien zu Fortbildung, Spielpädagogik und frühkindlichem Lernen. Besonders wichtig ist dabei die Unterscheidung zwischen wissenschaftlich belegten Erkenntnissen und praktischen Handlungsvorschlägen. Ein KI-System sollte nach Möglichkeit nachvollziehbar machen, auf welche Veröffentlichungen es sich bezieht und an welchen Stellen Unsicherheiten bestehen. Die fachliche Bewertung und die Entscheidung über die konkrete pädagogische Umsetzung bleiben bei den verantwortlichen Menschen.
ECE-Research-Corpus und EleMo: Wie hängen die Projekte zusammen?
Kita Digital arbeitet parallel an unterschiedlichen Bausteinen für spezialisierte KI in der Frühpädagogik. Während die ECE Wissens-Pipeline wissenschaftliche Veröffentlichungen für Recherche- und RAG-Anwendungen aufbereitet, verfolgt das Elementarpädagogische Modell EleMo einen anderen Entwicklungsansatz. EleMo ist ein spezialisiertes Sprachmodell für frühpädagogische Aufgaben. Die im Forschungsbericht beschriebene Version EleMo-V3 basiert auf einer eigenständigen pädagogischen Datenbasis. Eine Verbindung dieser Trainingsbasis mit dem ECE-Research-Corpus ist für eine spätere Modellgeneration vorgesehen.
Der ECE-Research-Corpus wurde im beschriebenen Forschungsprojekt also nicht als bereits nachgewiesene Trainingsgrundlage von EleMo-V3 eingesetzt.
Diese Trennung ist wichtig, um die jeweiligen Forschungs- und Entwicklungsstände korrekt einzuordnen.
Wie geht es mit der Forschung weiter?
Der Forschungsbericht benennt mehrere Aufgaben für die weitere Entwicklung. Dazu gehören insbesondere kontrollierte Vergleiche mit und ohne RAG, eine unabhängige fachliche Bewertung der Antworten sowie Untersuchungen dazu, welche Dokumentpassagen tatsächlich abgerufen und an das Sprachmodell übergeben werden. Auch die Qualität der aufbereiteten Texte und ein kontrollierter Offline-Test sollen künftig genauer überprüft werden. Ein weiterer Schwerpunkt ist die Frage, wie relevante Studieninformationen vollständiger gefunden und in Antworten berücksichtigt werden können. Die Ergebnisse der bisherigen Untersuchungen liefern dafür erste konkrete Ansatzpunkte.
Häufig gestellte Fragen zur lokalen KI in der Frühpädagogik
Was ist eine wissenschaftlich fundierte KI für die Kita?
Damit kann ein KI-System gemeint sein, das bei fachlichen Fragen gezielt auf überprüfbare wissenschaftliche Quellen zurückgreift. Eine angeschlossene Forschungsdatenbank kann die Nachvollziehbarkeit verbessern, garantiert aber keine richtigen Antworten.
Was ist der Unterschied zwischen RAG und dem Training einer KI?
Beim Training oder Fine-Tuning werden die Modellgewichte angepasst. Bei Retrieval-Augmented Generation werden dagegen relevante Informationen aus einer externen Wissenssammlung abgerufen und dem Sprachmodell bei der Beantwortung einer Frage zur Verfügung gestellt.
Kann eine Kita ein RAG-System ohne Cloud nutzen?
Technisch ist das möglich, wenn Sprachmodell, Embeddings, Vektordatenbank und weitere benötigte Komponenten lokal betrieben werden. Die konkrete Installation sowie Datenschutz- und Sicherheitsanforderungen müssen individuell geprüft werden.
Sind die Dokumente des ECE-Research-Corpus öffentlich zugänglich?
Der ECE-Research-Corpus ist als Forschungsdatensatz auf Hugging Face veröffentlicht. Für die enthaltenen wissenschaftlichen Werke gelten weiterhin deren jeweilige Lizenz- und Nutzungsbedingungen.
Kann KI pädagogische Fachkräfte durch wissenschaftliches Wissen ersetzen?
Nein. Wissenschaftliche KI-Assistenz kann bei Recherche, Informationsaufbereitung und Reflexion unterstützen. Pädagogische Verantwortung, professionelle Einschätzungen und Entscheidungen bleiben bei den Fachkräften.
Fazit: Gute KI in der Kita beginnt mit guten Wissensgrundlagen
Die Forschung zur ECE Wissens-Pipeline v1.0 verdeutlicht, wie anspruchsvoll es ist, wissenschaftliche Fachliteratur für spezialisierte KI-Systeme nutzbar zu machen. Aus 2.262 eindeutig identifizierten wissenschaftlichen Werken entstand in einem begrenzten Suchlauf ein Bestand von 151 übernommenen Dokumenten. Der explorative Vergleich von zehn KI-Antwortpaaren zeigte sowohl die Möglichkeiten quellenbezogener KI als auch ihre Grenzen. Die entscheidende Erkenntnis ist deshalb nicht, dass ein einzelnes Sprachmodell grundsätzlich besser wäre. Vielmehr wird sichtbar, wie wichtig geeignete Wissensbestände, transparente Quellen, kontrollierte Verarbeitung und menschliche Qualitätsprüfung für den verantwortungsvollen Einsatz von KI in der Frühpädagogik sind. Kita Digital möchte mit dieser Forschungsarbeit dazu beitragen, die technischen Grundlagen für spezialisierte, nachvollziehbare und lokal ausführbare KI-Systeme in der frühen Bildung weiterzuentwickeln.
Forschungsbericht und Projektquellen
Autor: Sebastian Götz, Kita Digital – Die KI-Insel der Frühpädagogik
Forschungsbericht: Automatisierte Kuratierung frühpädagogischer Wissenskorpora – Systemarchitektur der ECE Wissens-Pipeline v1.0 und explorative Evaluation lokaler RAG-Antworten.
Version 1.5, veröffentlicht am 18. Oktober 2026.
Die wissenschaftliche Auswertung und die beschriebenen Ergebnisse beruhen auf dem Forschungsbericht. Eine unabhängige, verblindete Evaluation wurde bislang nicht durchgeführt.
Öffentlich zugängliche Projektressourcen:
- ECE Wissens-Pipeline v1.0 – Softwarearchiv auf Zenodo
- ECE-Research-Corpus – Forschungsdaten auf Hugging Face
- EleMo-V3 – Modellkarte
DOI: https://doi.org/10.5281/zenodo.23447616
Mehr über unsere Arbeit erfahren: Auf ki-insel.de informieren wir über lokale KI-Systeme, frühpädagogische Assistenzmodelle und digitale Souveränität in Kindertageseinrichtungen. Sie möchten Fragen zum Einsatz lokaler KI in Ihrer Einrichtung klären? Nutzen Sie unsere Kita Digital Praxis-Sprechstunde.